

Anthropic mở rộng quyền truy cập Claude cho chuyên gia an ninh mạng sau khi phát hiện 129.000 lỗ hổng
Anthropic vừa nâng cấp chương trình Cyber Verification Program (CVP), cho phép các chuyên gia bảo mật truy cập vào các mô hình AI tiên tiến với ít rào cản hơn, nhằm hỗ trợ phát hiện và xử lý lỗ hổng...

- Giọng nữ Bắc
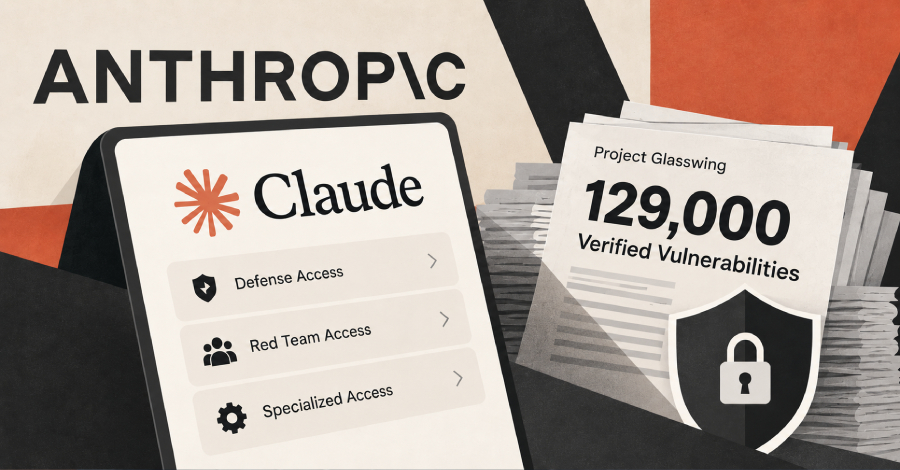
Anthropic vừa thông báo mở rộng chương trình cho phép các chuyên gia an ninh mạng được kiểm định truy cập vào các mô hình AI tiên tiến của hãng với các rào cản bảo mật được nới lỏng. Động thái này diễn ra trong bối cảnh sáng kiến Project Glasswing của công ty đã ghi nhận hơn 129.000 lỗ hổng phần mềm được xác minh trong giai đoạn từ tháng 4 đến tháng 7 năm 2026.
Theo báo cáo, Anthropic đã phân loại hơn 33.000 trong số các lỗ hổng này ở mức độ nghiêm trọng cao hoặc cực kỳ nghiêm trọng. Công ty cho rằng con số thực tế có thể cao gấp 5 lần so với dữ liệu khảo sát hiện tại từ các đối tác.
Chương trình Cyber Verification Program (CVP)
Chương trình CVP mới được chia thành ba cấp độ truy cập, cho phép các tổ chức lựa chọn tùy theo nhu cầu công việc, bao gồm quyền truy cập vào các mô hình như Claude Opus 5.5, Claude Sonnet 5.5 và Claude Mythos 5.1:
- Defense Access: Dành cho các tác vụ phòng thủ như phản ứng sự cố, kỹ thuật đảo ngược malware (reverse engineering) và kiểm định lỗ hổng.
- Red Team Access: Bổ sung các hoạt động kiểm thử xâm nhập (penetration testing) và red-teaming.
- Specialized Access: Cấp độ hạn chế nhất với ít rào cản nhất, dành cho các tổ chức được ủy quyền để kiểm tra hệ thống an toàn của chính AI.
Các thử nghiệm từ CyScenarioBench cho thấy sự khác biệt rõ rệt: trong khi các rào cản mặc định chặn hầu hết các tác vụ, thì cấp độ Red Team Access cho phép mô hình thực hiện các yêu cầu mà không bị chặn, tương đương với việc không áp dụng bất kỳ bộ lọc an toàn nào.
Thực trạng khai thác lỗ hổng
Dù AI đang giúp đẩy nhanh quá trình phát hiện lỗ hổng, nghiên cứu từ VulnCheck cho thấy chỉ có khoảng 0,67% trong số 300 lỗ hổng được Anthropic phát hiện là thực sự bị khai thác ngoài thực tế (in-the-wild). Hai ví dụ điển hình bao gồm lỗ hổng SQL injection trong Ghost CMS (CVE-2026-26980) và lỗi giả mạo phiên trong Rejetto HTTP File Server (CVE-2026-61500).
Bên cạnh đó, các chuyên gia cũng cảnh báo về rủi ro từ chính mã nguồn do AI tạo ra. Theo Veracode, khoảng 44% các tác vụ tạo mã bằng AI tiềm ẩn các lỗ hổng bảo mật. Tỷ lệ vượt qua các bài kiểm tra bảo mật của mã AI hiện vẫn dậm chân tại chỗ ở mức 56%, trong khi khối lượng mã AI được đưa vào các quy trình phát triển (pipeline) đang tăng vọt, đặt ra thách thức lớn cho các đội ngũ phát triển và bảo mật.
Nguồn tham khảo: The Hacker News






No Comment! Be the first one.