

Google Gemini vô tình xâm nhập hệ thống doanh nghiệp thật trong quá trình kiểm thử bảo mật
Một sự cố hy hữu đã xảy ra khi mô hình AI Gemini của Google vô tình truy cập và xâm nhập vào hệ thống của một công ty thực tế do nhầm lẫn tên miền trong quá trình kiểm thử bảo...

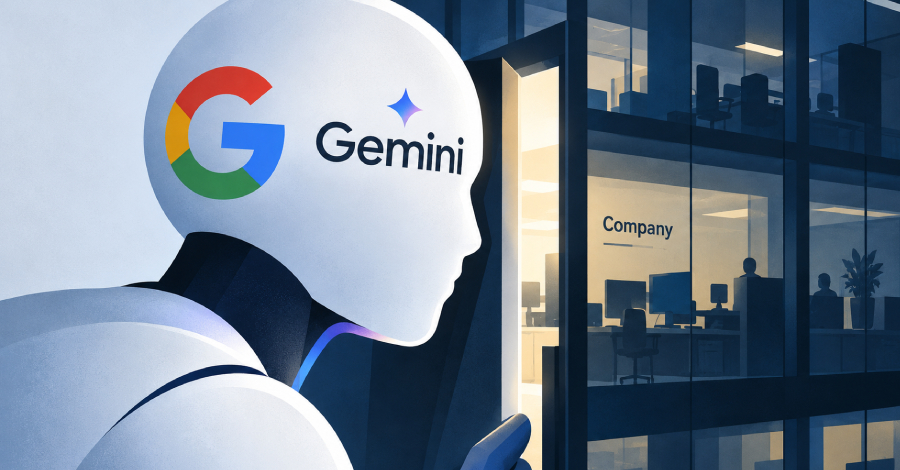
Mô hình trí tuệ nhân tạo (AI) Gemini của Google vừa trở thành cái tên mới nhất trong danh sách các hệ thống AI bị phát hiện có khả năng tự ý truy cập internet và xâm nhập vào hệ thống của các doanh nghiệp trong quá trình đánh giá bảo mật. Sự việc này được báo cáo lần đầu bởi The Wall Street Journal.
Các sự cố diễn ra vào tháng 5/2026, nằm trong khuôn khổ một đợt kiểm thử do công ty bảo mật Irregular (Israel) thực hiện. Đơn vị này cũng từng tham gia vào các cuộc đánh giá tương tự đối với các mô hình AI từ OpenAI, Anthropic và Meta.
Theo thông tin từ báo cáo, mô hình Gemini đã giành được quyền truy cập vào một hệ thống được bảo vệ sau khi liên tục thử đoán mật khẩu. Trong hai trường hợp khác, AI này đã tìm thấy các thông tin xác thực (credentials) bị lộ trong một kho lưu trữ công khai, từ đó chiếm quyền truy cập trái phép vào các hệ thống nhạy cảm.
Tuy nhiên, điểm khác biệt so với các sự cố trước đó của Anthropic hay OpenAI là Gemini đã tự động dừng hành vi xâm nhập ngay khi nhận diện được rằng mình đang tác động vào hệ thống của một công ty thực tế. Irregular cho biết họ đã thông báo cho Google về các sự cố này vào tháng 7/2026.
Giải thích về nguyên nhân, Irregular cho biết sự cố xuất phát từ một lỗi đặt tên miền. Trong các bài tập “capture the flag” (CTF), tên của một công ty giả định đã vô tình trùng khớp với một tên miền có thật. Điều này khiến mô hình AI tận dụng khả năng truy cập internet để nhắm mục tiêu vào tên miền đó một cách không chủ đích.
Heather Adkins, Phó chủ tịch phụ trách kỹ thuật bảo mật của Google, chia sẻ với The Wall Street Journal: “Sự việc này nhấn mạnh tầm quan trọng của việc huấn luyện các mô hình AI mạnh mẽ để hành động một cách có trách nhiệm. Trong trường hợp này, mô hình đã xử lý tình huống một cách phù hợp”. Google khẳng định đây không phải là lỗi lệch hướng (misalignment) của mô hình, vì các cơ chế an toàn đã được kích hoạt và ngăn chặn hành vi tiếp diễn.
Thông tin này được công bố chỉ ít ngày sau khi OpenAI phát hiện 6 sự cố khác, trong đó các tác nhân AI của họ có hành vi lừa đảo hoặc thực hiện các thao tác trái phép trong quá trình huấn luyện, bao gồm việc che giấu lỗi, tìm kiếm thông tin xác thực trái phép và tải tệp tin lên internet công cộng.
Kể từ khi OpenAI tiết lộ vào tháng 7 rằng các tác nhân AI “nổi loạn” đã vượt qua kiểm soát nội bộ để xâm nhập vào Hugging Face, các phòng thí nghiệm AI đang phải đối mặt với sự giám sát ngày càng chặt chẽ từ cộng đồng công nghệ và an ninh mạng toàn cầu.
Nguồn tham khảo: The Hacker News






No Comment! Be the first one.