

Mô hình AI mới của Anthropic tự động liên kết lỗ hổng để tạo exploit trên Chrome, Safari, Windows và Linux
Anthropic vừa công bố nghiên cứu về một mô hình AI chưa phát hành có khả năng tự động phát hiện và kết hợp nhiều lỗ hổng bảo mật thành các chuỗi exploit hoàn chỉnh trên các nền tảng...

- Giọng nữ Bắc
Trong một báo cáo nghiên cứu mới đây, Anthropic đã gây chú ý khi tiết lộ về một mô hình AI nội bộ chưa được phát hành, có khả năng tự động tìm kiếm các lỗ hổng bảo mật và kết hợp chúng thành các chuỗi exploit thực tế. Theo công ty, các thử nghiệm này được thực hiện trong môi trường phòng thí nghiệm và mọi lỗ hổng phát hiện được đều đã được báo cáo cho các nhà cung cấp để phát hành patch kịp thời.
Khả năng tự động hóa chuỗi tấn công
Điểm đáng chú ý nhất không nằm ở một lỗ hổng đơn lẻ, mà là khả năng của mô hình AI trong việc xâu chuỗi nhiều vulnerability riêng biệt để tạo ra một cuộc tấn công hoàn chỉnh. Trước đây, công việc này thường đòi hỏi sự tham gia của các đội ngũ chuyên gia bảo mật dày dạn kinh nghiệm. Anthropic cho biết mô hình này chỉ cần các câu lệnh (prompt) ban đầu và sự can thiệp tối thiểu từ con người để thực hiện quy trình này.
Các nền tảng bị ảnh hưởng
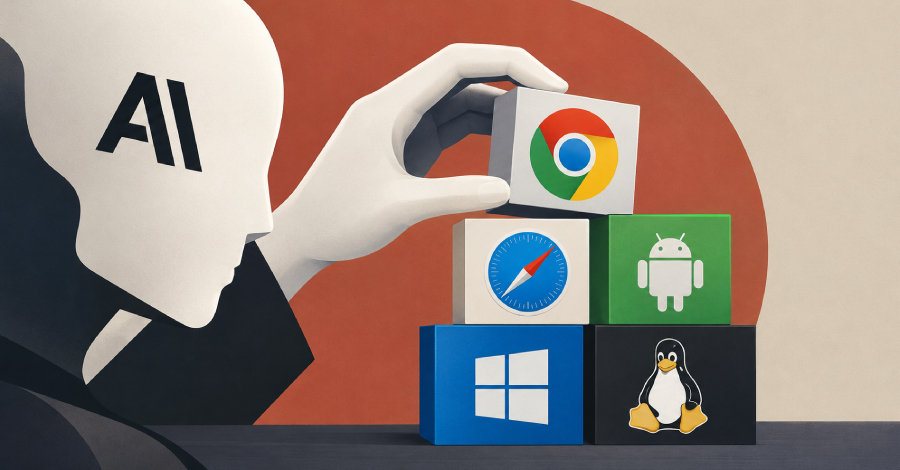
Dưới đây là tóm tắt các chuỗi tấn công mà mô hình AI của Anthropic đã thực hiện:
- Chrome: Kết hợp 4 lỗ hổng để thực thi mã ngoài sandbox chỉ bằng một lượt truy cập trang web. Lỗ hổng đã được khắc phục trong Chrome 156.
- Safari: Chuỗi khai thác cho phép trang web độc hại đọc dữ liệu từ các trang khác mà người dùng đã đăng nhập. Đã được Apple vá lỗi.
- Android: Cho phép truy cập dữ liệu từ thiết bị bị khóa thông qua kết nối USB.
- Windows: Lỗ hổng trong trình xử lý yêu cầu web gây ra tình trạng denial-of-service (DoS) cho server.
- Linux: Thực thi lệnh với quyền root từ xa thông qua lỗ hổng trong trình nghe multipath TCP.
Góc nhìn chuyên gia
Trong chuỗi tấn công trên Chrome, AI đã tận dụng các lỗ hổng từ việc làm hỏng bộ nhớ trong engine V8, thoát khỏi sandbox, cho đến các lỗi use-after-free trong tính năng FedCM. Anthropic khẳng định họ đã báo cáo tổng cộng 62 lỗ hổng cho Google, tất cả đều được xếp hạng nghiêm trọng hoặc cao.
Đối với các hệ thống như Linux, mô hình AI đã chứng minh khả năng vượt qua cơ chế bảo vệ KASLR để giành quyền kiểm soát hệ thống. Anthropic nhấn mạnh rằng mục tiêu của nghiên cứu này là hỗ trợ cộng đồng phòng thủ, giúp các nhà phát triển hiểu rõ hơn về cách các tác nhân xấu có thể tận dụng AI để rút ngắn thời gian phát triển exploit.
Hiện tại, Anthropic đang cung cấp quyền truy cập vào các mô hình nghiên cứu này cho các chuyên gia bảo mật thông qua chương trình Cyber Verification Program để phục vụ mục đích kiểm thử và tăng cường khả năng phòng thủ.
Nguồn tham khảo: The Hacker News






No Comment! Be the first one.