

Giám đốc chính sách Hugging Face: Đánh giá AI nhúng không phải là giải pháp dễ dàng
Irene Solaiman từ Hugging Face cảnh báo rằng việc dựa vào các đơn vị đánh giá AI bên thứ ba vẫn còn nhiều bất cập về tính chuẩn hóa và khả năng tái lập kết...

- Giọng nữ Bắc
Các phòng thí nghiệm AI hiện nay đang đặt cược uy tín vào các hệ thống benchmarking – những quy trình đánh giá được kỳ vọng là trung lập và chính xác để đo lường hiệu năng giữa các sản phẩm AI. Tuy nhiên, Irene Solaiman, Giám đốc chính sách tại Hugging Face, cho rằng các phương pháp này vẫn còn phức tạp và chưa thực sự hoàn thiện.
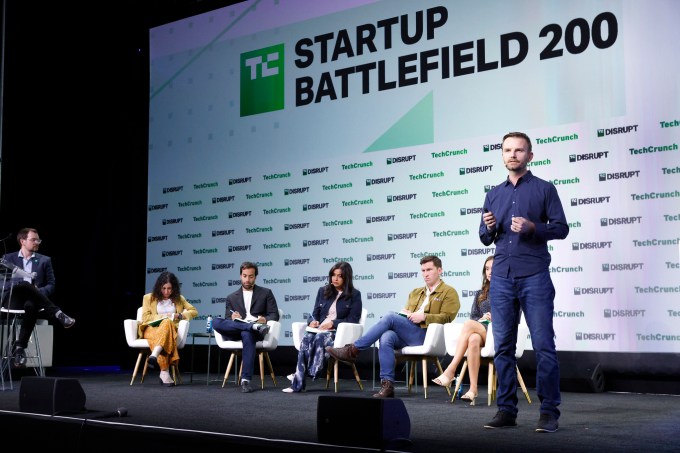
Tại sự kiện TechCrunch Disrupt, bà Solaiman nhấn mạnh rằng ngành công nghiệp cần một cách tiếp cận khoa học và nhất quán hơn nếu muốn thực sự tin tưởng vào các kết quả đánh giá trong tương lai. Một trong những rào cản lớn nhất hiện nay là khả năng tái lập kết quả (reproducibility). Theo bà, việc tiếp cận sâu vào mô hình là yếu tố then chốt, và đây chính là lý do tại sao các mô hình có trọng số mở (open weights) đóng vai trò quan trọng.
Vấn đề không chỉ dừng lại ở tính hợp lệ của từng bài kiểm tra đơn lẻ, mà còn là sự thiếu hụt một hệ sinh thái chuẩn hóa để so sánh các kết quả đánh giá với nhau. Các bài kiểm tra hiện nay nhanh chóng trở nên lỗi thời và thiếu sự thống nhất về tiêu chuẩn đánh giá năng lực của các đơn vị kiểm định.
Khái niệm “embedded evaluators” (đánh giá viên nhúng) – nơi các bên thứ ba trung lập được đưa vào nội bộ tổ chức AI – đang trở thành xu hướng trong bối cảnh các phòng thí nghiệm AI đối mặt với nhiều sự cố an toàn. Tuy nhiên, mô hình này vẫn vấp phải sự hoài nghi. Điển hình như việc Anthropic thuê Accenture làm đơn vị đánh giá đã gây ra làn sóng tranh cãi về năng lực chuyên môn của các công ty tư vấn trong lĩnh vực kỹ thuật phức tạp này.
Bà Solaiman cũng chỉ ra rằng trọng tâm đánh giá đang chuyển dịch từ bản thân mô hình sang toàn bộ hệ thống xung quanh, bao gồm cả các công cụ hỗ trợ (harness) và tác nhân (agent). Một mô hình yếu hơn nếu được kết hợp với một hệ thống harness tốt vẫn có thể vượt qua các mô hình tiên tiến nhất. Hiện tại, việc đánh giá các agentic AI vẫn rất khó khăn và tốn kém, trong khi các công cụ để kiểm định harness lại chưa được chú trọng đúng mức.
Tóm lại, lĩnh vực đánh giá AI hiện nay vẫn đang ở trạng thái “mạnh ai nấy làm”. Để benchmarking tiếp tục là công cụ hữu ích cho các nhà lãnh đạo ngành, một khung tiêu chuẩn chung trên toàn ngành là điều bắt buộc phải có trong thời gian tới.
Nguồn tham khảo: TechCrunch



No Comment! Be the first one.