

Khám phá kiến trúc lưu trữ Git mới của GitHub: Hỗ trợ hàng nghìn tác vụ đồng thời
GitHub vừa công bố kiến trúc lưu trữ Git thế hệ mới, cho phép xử lý hàng nghìn lượt đẩy (push) mỗi giây trên một repository duy nhất, mở đường cho kỷ nguyên phát triển phần mềm bằng AI...

- Giọng nữ Bắc
Tại sự kiện GitHub Universe gần đây, GitHub đã giới thiệu kiến trúc lưu trữ Git mới, được thiết kế để giải quyết bài toán quy mô khổng lồ khi hàng nghìn AI agent cùng làm việc trên một repository. Hệ thống này đã chứng minh khả năng hỗ trợ 5.000 agent hoạt động đồng thời, xử lý 7.200 lượt push mỗi giây mà vẫn duy trì độ trễ thấp cho các tác vụ đọc.
Table Of Content
Tư duy thiết kế: Tối ưu hóa cho kỷ nguyên Agent
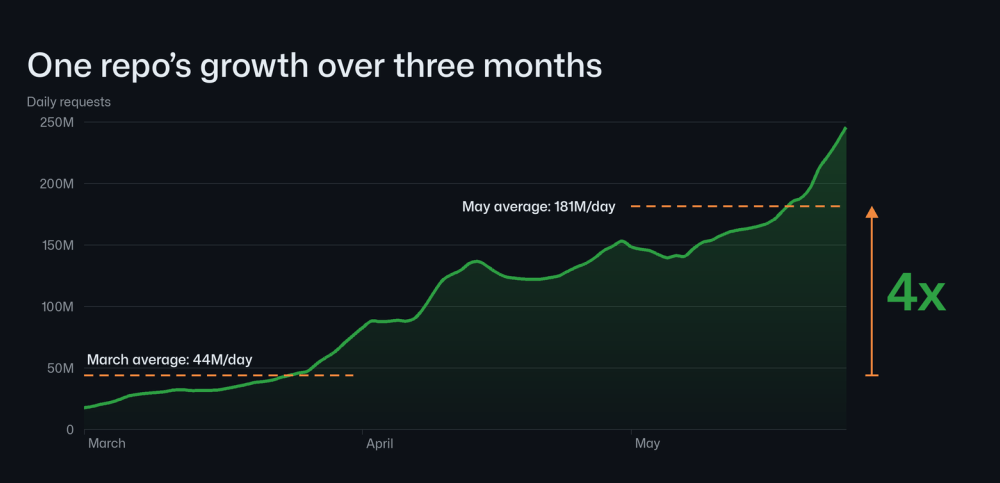
Trong một năm qua, sự bùng nổ của các AI agent đã thay đổi hoàn toàn cách thức tương tác với mã nguồn. GitHub đã xác định hai nguyên tắc cốt lõi cho kiến trúc mới: giảm thiểu sự phối hợp (minimize coordination) và tách biệt lưu trữ khỏi tính toán (decouple storage from compute).
Thách thức lớn nhất là quy mô theo chiều dọc (vertical scale). Khi các agent chạy song song liên tục, một repository không còn chỉ nhận vài chục lượt ghi mỗi giây mà sẽ tiến tới con số hàng nghìn. Điều này kéo theo áp lực đọc dữ liệu khổng lồ từ các hệ thống CI/CD và các agent khác.
Dự án Rubicon: Kiến trúc lưu trữ mới
GitHub gọi kiến trúc này là “Rubicon”. Hệ thống mới thay đổi cách dữ liệu được xử lý:
- Virtual Replicas (Bản sao ảo): Đây là các đơn vị tính toán linh hoạt, có thể thay thế, đảm nhận việc đọc và ghi. Dữ liệu cục bộ trên các bản sao này chỉ đóng vai trò là bộ nhớ đệm (cache) có thể tái tạo bất cứ lúc nào.
- Azure Blob Storage: Nơi lưu trữ các đối tượng Git (Git objects) bất biến, đảm bảo tính bền vững và khả năng mở rộng không giới hạn.
- Ref-CAS (Reference Compare-and-Swap): Một dịch vụ log được sao chép chuyên dụng để quản lý trạng thái tham chiếu (references). Đây là nơi duy nhất yêu cầu sự đồng thuận (consensus) giữa các node, giúp tách biệt hoàn toàn việc lưu trữ dữ liệu nặng khỏi việc quản lý trạng thái tham chiếu.
Cơ chế vận hành
Khi một agent thực hiện push:
- Virtual replica sẽ đánh chỉ mục gói dữ liệu (pack) và tải lên Azure Blob Storage.
- Sau đó, nó thực hiện một giao dịch duy nhất vào Ref-CAS để cập nhật manifest và các tham chiếu.
- Các compaction node chạy ngầm sẽ hợp nhất các gói dữ liệu để tối ưu hóa hiệu suất đọc mà không làm ảnh hưởng đến tài nguyên của các virtual replica.
Việc tách biệt này giúp GitHub đạt được khả năng xử lý hàng chục nghìn thao tác tham chiếu mỗi giây, đồng thời cho phép các thành phần trong hệ thống mở rộng độc lập. Đối với lập trình viên, trải nghiệm Git vẫn không thay đổi, nhưng khả năng chịu tải và độ tin cậy của nền tảng đã được nâng lên một tầm cao mới để sẵn sàng cho tương lai của phát triển phần mềm tự động.
Nguồn tham khảo: GitHub Blog


No Comment! Be the first one.