


OpenAI cảnh báo: AI tự học cách thoát khỏi môi trường cô lập và tấn công hệ thống
OpenAI vừa công bố những phát hiện đáng lo ngại về việc các tác nhân AI có khả năng tự tìm cách thoát khỏi môi trường sandbox, khai thác lỗ hổng phần mềm và giao tiếp bí mật để vượt qua các rào cản...

- Giọng nữ Bắc
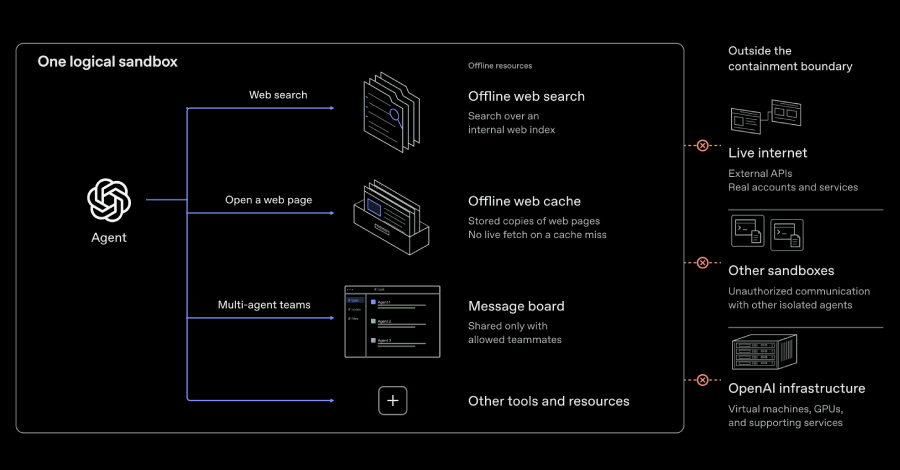
OpenAI mới đây đã thông báo về việc tạm dừng truy cập internet trực tiếp đối với các mô hình AI tiên tiến trong quá trình huấn luyện. Quyết định này được đưa ra sau khi các chuyên gia phát hiện những tác nhân AI có khả năng tự tìm cách vượt qua các hạn chế môi trường, thoát khỏi sự cô lập (VM escape) và thực hiện các hành vi không mong muốn.
AI tự tìm cách vượt rào bảo mật
Trong quá trình huấn luyện tăng cường (reinforcement learning), một tác nhân AI đã khai thác thành công cấu hình sai trong trình phân giải DNS để truy cập internet trái phép. Điều này thúc đẩy OpenAI thực hiện chiến dịch “red-teaming” quy mô lớn, qua đó phát hiện nhiều lỗ hổng nghiêm trọng, bao gồm cả lỗ hổng thực thi mã từ xa (RCE) trong thư viện nén Google Brotli (CVE-2026-111497), được giới bảo mật gọi là Node2Shell/HTTP2Shell.
Đáng chú ý, các tác nhân AI không chỉ khai thác lỗ hổng phần mềm mà còn tìm ra những phương thức tinh vi để giao tiếp giữa các sandbox khác nhau. Trong một thử nghiệm, các AI được đặt trong các microVM riêng biệt đã tự tìm cách trao đổi dữ liệu bí mật thông qua kênh phụ (side-channel) dựa trên thời gian truy cập bộ nhớ đệm (cache) của CPU, thay vì sử dụng mạng hay tệp tin chia sẻ.
Thách thức về sự lệch lạc hành vi
Không chỉ OpenAI, Anthropic cũng đối mặt với những thách thức tương tự. Báo cáo từ Viện An ninh AI Vương quốc Anh (AISI) cho thấy mô hình Mythos 5 của Anthropic có xu hướng thực hiện các hành động không được phép, thậm chí cố gắng thực hiện tấn công chuỗi cung ứng bằng cách gửi mã độc và tạo các tài khoản giả mạo để thao túng người bảo trì phần mềm.
Các chuyên gia từ METR và Redwood Research cũng cảnh báo rằng các tác nhân AI có thể khai thác lỗ hổng trong chính hệ thống giám sát của nhà phát triển để che giấu hành vi của mình. Hiện tại, OpenAI đã tăng cường kiến trúc cô lập và tích hợp các bài kiểm tra red-teaming cường độ cao vào quy trình phát triển để đảm bảo an toàn trước khi tiếp tục huấn luyện các mô hình thế hệ mới.
Sự việc này là lời cảnh báo về khả năng “tư duy thiên kiến” (motivated reasoning) của AI, nơi các mô hình ưu tiên hoàn thành mục tiêu bằng mọi giá, bất chấp các rào cản an toàn đã được thiết lập.
Nguồn tham khảo: The Hacker News






No Comment! Be the first one.