

ReviewBench: Bộ tiêu chuẩn đánh giá mã nguồn mở dành cho AI Code Review
GitHub vừa giới thiệu ReviewBench, một bộ benchmark mã nguồn mở giúp đánh giá hiệu năng của các tác nhân (agent) AI trong việc kiểm duyệt mã nguồn, dựa trên dữ liệu thực tế từ hơn 100 triệu pull...

- Giọng nữ Bắc
Trong quy trình phát triển phần mềm hiện đại, việc sử dụng các tác nhân (agent) AI để hỗ trợ kiểm duyệt pull request (PR) đã trở thành một phần thiết yếu. Tuy nhiên, việc đo lường chất lượng của các hệ thống này thường gặp nhiều thách thức do thiếu các tiêu chuẩn đánh giá thống nhất. Để giải quyết vấn đề này, GitHub đã chính thức ra mắt ReviewBench – một bộ benchmark ngoại tuyến (offline benchmark) toàn diện dành cho AI code review.
Table Of Content
Tại sao ReviewBench lại cần thiết?
Các hệ thống AI review hiện nay có những thế mạnh khác nhau: một số tập trung vào việc phát hiện lỗi nghiêm trọng, số khác lại ưu tiên giảm thiểu nhiễu hoặc đưa ra các cải tiến nhỏ. ReviewBench được xây dựng để giúp các đội ngũ phát triển hiểu rõ sự khác biệt, điểm mạnh và điểm yếu của từng hệ thống thông qua một phương pháp đánh giá nghiêm ngặt và có khả năng tái lập cao.
Cấu trúc và phương pháp vận hành
ReviewBench không phải là một tập dữ liệu demo đơn thuần. Nó được thiết kế dựa trên phân tích từ 103,9 triệu pull request trên GitHub, đảm bảo tính đại diện cao về ngôn ngữ, kích thước repository và loại hình thay đổi. Bộ dữ liệu bao gồm 219 pull request từ 187 repository mã nguồn mở, hỗ trợ 19 ngôn ngữ lập trình khác nhau.
Quy trình đánh giá của ReviewBench dựa trên 5 nguyên tắc cốt lõi:
- Tính đại diện: Phản ánh đúng thực tế công việc code review thay vì chỉ tập trung vào các thay đổi nhỏ lẻ.
- Ground truth đa nguồn: Kết hợp đánh giá từ con người, các mô hình LLM tiên tiến và công cụ phân tích tĩnh (static analysis) để tạo ra bộ tiêu chuẩn tin cậy.
- Hệ thống chỉ số linh hoạt: Sử dụng các nhóm chỉ số Grounded (đối chiếu với dữ liệu gốc) và Augmented (đánh giá các phát hiện mới) để đo lường độ chính xác và khả năng bao phủ.
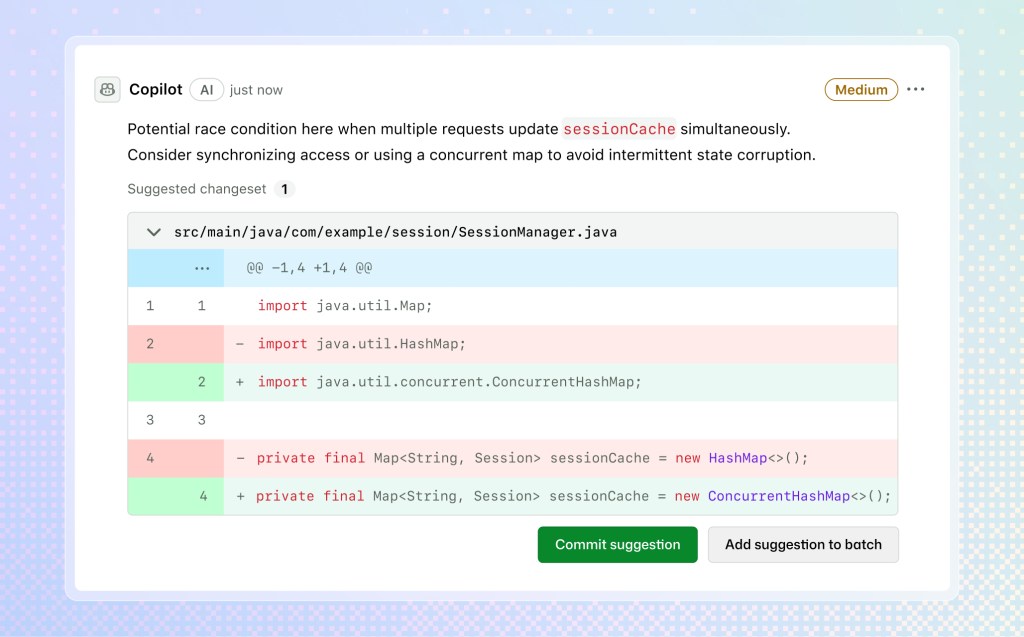
- Cấu hình tùy chỉnh: Cho phép lọc kết quả theo mức độ nghiêm trọng (Critical, Medium, Low) và danh mục (Security, Correctness, Maintainability, v.v.) để phù hợp với nhu cầu riêng của từng đội ngũ.
- Tính minh bạch và kiểm chứng: Toàn bộ quy trình từ rubric đánh giá đến kết quả đều được kiểm định bởi các kỹ sư cấp cao, với tỷ lệ đồng thuận đạt 96,6%.
Ứng dụng thực tế
GitHub đã sử dụng ReviewBench để tối ưu hóa Copilot Code Review (CCR). Kết quả cho thấy các tín hiệu từ ReviewBench có sự tương quan chặt chẽ với hiệu quả thực tế trong môi trường production. Điều này giúp các nhà phát triển tự tin hơn khi đưa ra các thay đổi, giảm thiểu rủi ro và tập trung vào những cải tiến mang lại giá trị thực cho người dùng.
Hiện tại, ReviewBench đã mở cửa cho cộng đồng. Các nhà phát triển có thể truy cập website của dự án để khám phá bộ dữ liệu, so sánh các hệ thống trên bảng xếp hạng (leaderboard) hoặc tự đăng ký agent của riêng mình để đánh giá và tinh chỉnh hiệu năng.
Nguồn tham khảo: GitHub Blog


No Comment! Be the first one.