

Goodfire ra mắt công nghệ giám sát ‘inside-out’ giúp phát hiện tác nhân AI độc hại với chi phí tối ưu
Startup Goodfire giới thiệu phương pháp giám sát AI mới bằng cách đọc các tín hiệu nội bộ của mô hình, giúp phát hiện các hành vi bất thường của AI agent với chi phí thấp hơn nhiều so với các giải...

- Giọng nữ Bắc
Việc giám sát các AI agent hiện nay thường dựa vào một mô hình AI thứ hai để kiểm soát hành vi của mô hình chính. Dù là phương pháp tiêu chuẩn, cách tiếp cận này tiêu tốn rất nhiều tài nguyên và chi phí khi các agent phải hoạt động liên tục trong thời gian dài.
Table Of Content
Goodfire, một startup chuyên về khả năng diễn giải (interpretability) của AI, vừa giới thiệu một giải pháp thay thế hiệu quả hơn. Thay vì chỉ đọc kết quả đầu ra, hệ thống của Goodfire thực hiện giám sát ngay từ bên trong mô hình khi nó đang xử lý dữ liệu. Công nghệ này hiện đã được tích hợp cho khách hàng của Baseten, nền tảng chuyên cung cấp hạ tầng chạy mô hình AI.
Cơ chế hoạt động như máy quét an ninh
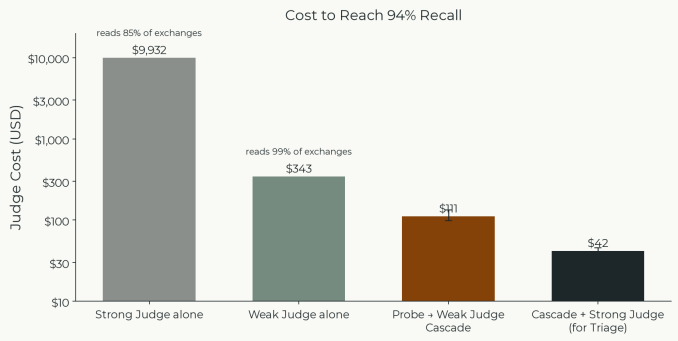
Hệ thống của Goodfire vận hành tương tự như quy trình kiểm soát an ninh tại sân bay. Các bộ dò nhỏ gọi là probes sẽ đọc các tín hiệu nội bộ của mô hình tại mỗi bước xử lý. Chỉ khi các probes này phát hiện dấu hiệu bất thường, một mô hình AI riêng biệt mới được kích hoạt để kiểm tra chuyên sâu, tương tự như việc kiểm tra hành lý thủ công.
Người dùng Baseten có thể tùy chỉnh các rủi ro cần giám sát, từ hành vi tấn công mạng, sử dụng vũ khí hóa học/sinh học cho đến các hành vi thao túng phần thưởng (reward hacking). Sau khi phát hiện, hệ thống có thể tự động ghi nhật ký, chuyển cho con người xem xét hoặc chặn yêu cầu ngay lập tức.
Hiệu quả về chi phí và tốc độ
Điểm mạnh của Goodfire nằm ở khả năng tái sử dụng các tính toán mà mô hình đang thực hiện. CEO Eric Ho giải thích rằng thay vì bắt mô hình phải đọc lại toàn bộ dữ liệu, các probes chỉ đơn giản là đọc các kết quả trung gian từ các lớp thần kinh (neural activations) đã được tính toán sẵn. Điều này giúp giảm đáng kể chi phí vận hành.
Trong các thử nghiệm trên mô hình Kimi K3, việc giám sát 1.500 phiên làm việc chỉ tốn khoảng 51 USD, trong khi các giải pháp AI kiểm tra từng bước truyền thống có thể tốn từ 233 USD đến 10.000 USD. Ngoài ra, việc chạy bốn probes cùng lúc chỉ làm tăng chưa đầy 2% thời gian phản hồi của mô hình.
Tầm quan trọng đối với các mô hình mã nguồn mở
Giải pháp này đặc biệt hữu ích cho các mô hình mã nguồn mở, vốn thường bị lược bỏ các lớp bảo vệ và thiếu cơ chế giám sát chặt chẽ như các mô hình đóng. CTO Dan Balsam nhấn mạnh: “Chúng tôi có thể phát hiện khi nào mô hình có khả năng thực hiện hành vi tấn công ngay trong quá trình huấn luyện hoặc đánh giá”.
Nghiên cứu của Goodfire cho thấy nhiều mô hình mã nguồn mở hàng đầu hiện nay có tỷ lệ bị thao túng phần thưởng từ 50% đến 96% trong các bài kiểm tra. Với công nghệ này, Goodfire hy vọng sẽ biến quá trình huấn luyện AI từ một ‘hộp đen’ đầy bí ẩn trở thành một quy trình kỹ thuật chính xác hơn trong tương lai.
Nguồn tham khảo: TechCrunch


No Comment! Be the first one.